PDF digitalizado para texto (OCR)
Seu PDF digitalizado é só uma imagem e o texto não pode ser selecionado nem copiado? Envie-o e o OCR o transforma em texto copiável, gerando um .txt e um PDF pesquisável (uma camada de texto invisível sobre as páginas originais, pronta para busca de texto completo). Escolha entre 9 idiomas de reconhecimento. O reconhecimento roda localmente no seu navegador; seu arquivo nunca é enviado.
- Envie a digitalização
- OCR local
- Baixe o texto
Arraste seu arquivo aqui
ou escolha no seu dispositivo — sem cadastro
Os arquivos são processados localmente no seu navegador — nunca são enviados a nenhum servidor
Prévia de preço da versão final: US$ 6,9/mês ou US$ 49/ano · aviso por e-mail 30 dias antes da cobrança · nada é cobrado durante o beta
Como fica o resultado
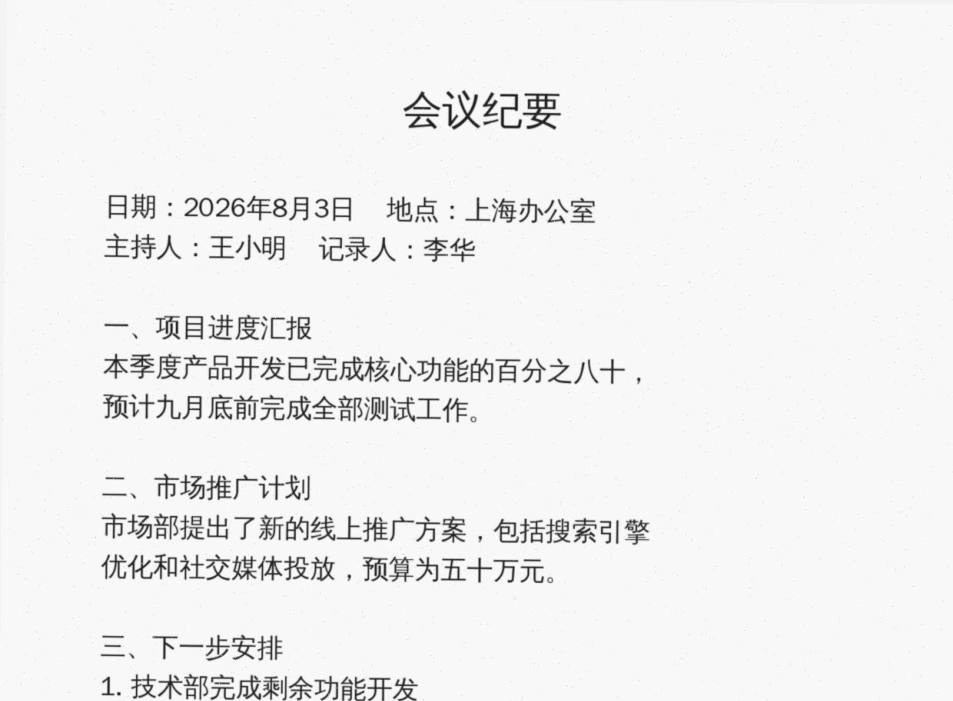
会议纪要
日期: 2026 年 8 月 3 日 ”地点:上海办公室
主持人:王小明 ”记录人:李华
一、项目进度汇报
本季度产品开发已完成核心功能的百分之八十,
预计九月底前完成全部测试工作。
O texto acima é um trecho sem edição do que nosso mecanismo de OCR realmente produziu a partir do exemplo digitalizado. Clique em “Testar com um PDF de exemplo” acima para reproduzir.
Como funciona (3 passos)
Envie a digitalização
PDFs digitalizados e imagens PNG/JPG são aceitos; escolha o idioma de reconhecimento do seu documento.
OCR local
As páginas são reconhecidas uma a uma com progresso visível; digitalizações impressas nítidas dão alta precisão. O modelo de OCR roda dentro do seu navegador.
Baixe o texto
Você recebe um .txt de texto simples e um PDF pesquisável que mantém o layout original.
Buscas populares
- converter PDF digitalizado em texto
- extrair texto de PDF digitalizado
- tornar PDF digitalizado pesquisável
Perguntas frequentes
Texto impresso digitalizado a 300dpi ou mais é bem reconhecido; conteúdo torto, borrado ou manuscrito perde bastante precisão — confira números e nomes importantes após o OCR.
Experimente ↑Ele parece idêntico à digitalização original, mas cada página carrega uma camada de texto invisível: você pode selecionar e copiar texto, buscar com Ctrl+F, e sistemas de documentos podem indexá-lo.
Experimente ↑Chinês simplificado e tradicional, inglês, japonês, coreano, alemão, francês, espanhol e português — 9 no total; opções não inglesas reconhecem texto misto com inglês automaticamente.
Experimente ↑Não — o OCR roda inteiramente no seu navegador. O modelo de reconhecimento é baixado de um CDN no primeiro uso (veja o aviso no rodapé).
Experimente ↑Não. Qualquer alteração em um PDF assinado (unir, comprimir, marca d’água…) invalida a assinatura digital existente — é o design antiviolação das assinaturas PDF, não um limite deste site. Processe primeiro, depois assine.
Experimente ↑Sim — e você pode verificar: a ferramenta usa mecanismos de código aberto no navegador (pdf-lib, pdf.js, Tesseract OCR…) no seu próprio dispositivo. Abra DevTools → Network durante o processamento e verá que nenhum arquivo é enviado.
Experimente ↑Ferramentas relacionadas
OCR — PDF para texto
Transforme PDFs digitalizados em texto selecionável e pesquisável em 9 idiomas de reconhecimento (português, inglês, chinês simplificado/tradicional, japonês, coreano, alemão, francês, espanhol) — exporte .txt ou um PDF pesquisável
PDF digitalizado para Word
Obtenha um .docx editável do seu PDF
Tabela de PDF para Excel
Extraia tabelas de qualquer PDF com texto para .xlsx ou CSV — notas fiscais, relatórios, listas de preços, extratos