スキャン PDF をテキスト化(OCR)
スキャンした PDF はただの画像で、文字を選択もコピーもできない?アップロードすれば OCR がコピー可能なテキストに変換し、.txt と検索可能 PDF(元のページに透明テキスト層を重ねて全文検索に対応)の両方を出力します。認識言語は 9 種から選択可能。認識はブラウザ内で実行され、ファイルはアップロードされません。
- スキャンをアップロード
- ローカル OCR
- テキストをダウンロード
ここにファイルをドロップ
または端末から選択 — 登録不要
ファイルはブラウザ内でローカル処理され、サーバーには一切アップロードされません
正式版の価格予告:$6.9/月 または $49/年 · 課金開始の 30 日前にメールで通知 · ベータ期間中は一切課金されません
認識結果のイメージ
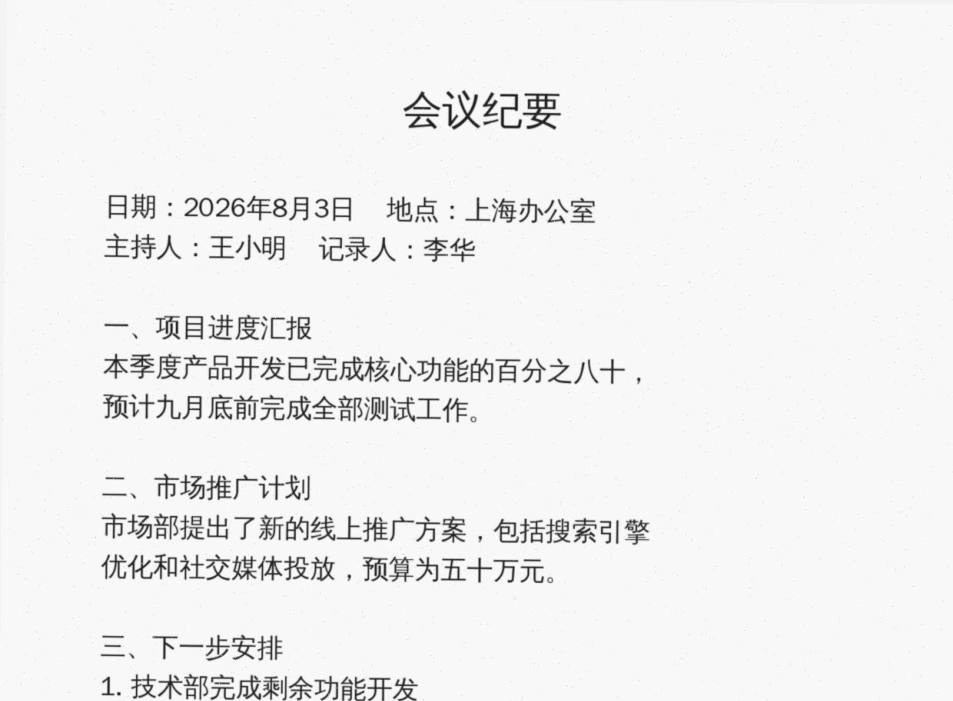
会议纪要
日期: 2026 年 8 月 3 日 ”地点:上海办公室
主持人:王小明 ”记录人:李华
一、项目进度汇报
本季度产品开发已完成核心功能的百分之八十,
预计九月底前完成全部测试工作。
上記はサンプルスキャンに対して当サイトの OCR エンジンが実際に出力した無修正の抜粋です。上の「サンプル PDF で試す」から再現できます。
使い方(3 ステップ)
スキャンをアップロード
スキャン PDF と PNG/JPG 画像に対応。文書に合った認識言語を選択してください。
ローカル OCR
ページごとに進捗を表示しながら認識します。鮮明な印刷スキャンなら高精度。OCR モデルはブラウザ内で動作します。
テキストをダウンロード
プレーンテキストの .txt と、元のレイアウトを保った検索可能 PDF の両方が得られます。
よく検索される用途
- スキャン PDF 文字起こし
- スキャン PDF テキスト抽出
- スキャン PDF 検索可能にする
よくある質問
300dpi 以上でスキャンした印刷文字は高精度で認識されます。傾き・ぼやけ・手書きは精度が大きく下がるため、OCR 後に重要な数字や名前を確認してください。
試してみる ↑見た目は元のスキャンと同一ですが、各ページに透明なテキスト層が載っています。文字の選択・コピー、Ctrl+F での検索ができ、文書管理システムのインデックスにも対応します。
試してみる ↑簡体字・繁体字中国語、英語、日本語、韓国語、ドイツ語、フランス語、スペイン語、ポルトガル語の計 9 種。英語以外のオプションは英語との混在テキストも自動認識します。
試してみる ↑いいえ。OCR はすべてブラウザ内で実行されます。認識モデルは初回利用時に CDN からダウンロードされます(フッターの開示をご覧ください)。
試してみる ↑無効になります。署名済み PDF への変更(結合・圧縮・透かしなど)は既存の電子署名を無効化します。これは PDF 署名の改ざん防止設計であり、本サイトの制限ではありません。処理後に署名してください。
試してみる ↑はい。ブラウザ内で動くオープンソースエンジン(pdf-lib、pdf.js、Tesseract OCR など)をあなたの端末上で実行しており、コードは公開されています。処理中に DevTools → Network を開けば、ファイルのアップロードが一切ないことを確認できます。
試してみる ↑