OCR — PDF scanné en texte
Transformez les PDF scannés en texte sélectionnable et interrogeable dans 9 langues de reconnaissance (français, anglais, chinois simplifié/traditionnel, japonais, coréen, allemand, espagnol, portugais) — exportez un .txt ou un PDF interrogeable. L’OCR s’exécute localement dans votre navigateur via WebAssembly ; votre document n’est jamais téléversé.
- Envoyez un scan et choisissez la langue
- OCR local
- Téléchargez le texte ou le PDF interrogeable
Déposez votre fichier ici
ou choisissez depuis votre appareil — sans inscription
Les fichiers sont traités localement dans votre navigateur — jamais envoyés à un serveur
Aperçu des prix de la version finale : 6,9 $/mois ou 49 $/an · préavis par e-mail 30 jours avant facturation · rien n’est facturé pendant la bêta
À quoi ressemble le résultat
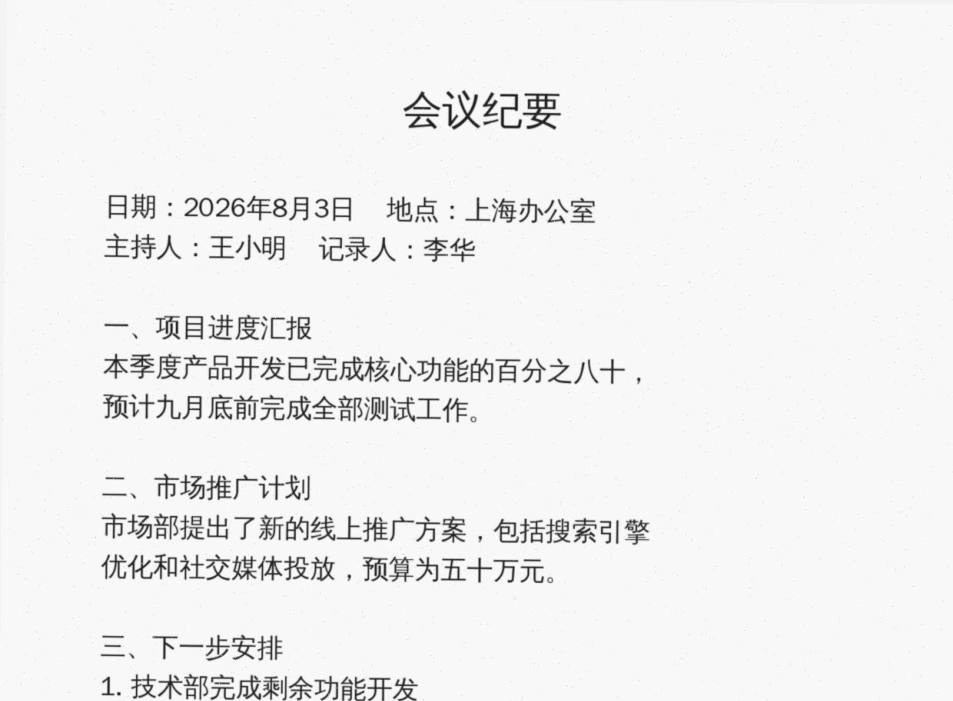
会议纪要
日期: 2026 年 8 月 3 日 ”地点:上海办公室
主持人:王小明 ”记录人:李华
一、项目进度汇报
本季度产品开发已完成核心功能的百分之八十,
预计九月底前完成全部测试工作。
Le texte ci-dessus est un extrait non retouché de ce que notre moteur OCR a réellement produit à partir du scan d’exemple. Cliquez sur « Essayer avec un PDF d’exemple » ci-dessus pour le reproduire.
Comment ça marche (3 étapes)
Envoyez un scan et choisissez la langue
Les scans nets et droits fonctionnent le mieux. Chaque modèle de langue se télécharge au premier usage (une seule fois, de quelques Mo à ~20 Mo).
OCR local
Chaque page est rendue et reconnue dans votre navigateur avec une progression visible par page.
Téléchargez le texte ou le PDF interrogeable
Exportez un .txt, ou un PDF interrogeable avec une couche de texte invisible sur le scan original.
Recherches populaires
- OCR de PDF en ligne gratuit multilingue
- PDF scanné en PDF interrogeable
- extraire le texte d’un PDF scanné
Questions fréquentes
Non. La reconnaissance s’exécute dans votre navigateur via WebAssembly (tesseract.js). Le modèle de langue est chargé une fois depuis un CDN ; votre fichier ne quitte jamais votre appareil.
Essayer ↑Les bons scans de texte imprimé sont généralement bien reconnus ; l’écriture manuscrite et les scans de mauvaise qualité sont aléatoires. Choisissez la langue de reconnaissance correspondant au document — une mauvaise langue dégrade nettement la précision. Relisez toujours. Les échecs remboursent automatiquement votre quota.
Essayer ↑Votre scan original avec une couche de texte invisible par-dessus — il paraît identique mais vous pouvez sélectionner, copier et rechercher le texte.
Essayer ↑Non. Toute modification d’un PDF signé (fusion, compression, filigrane…) invalide la signature numérique existante — c’est la protection anti-falsification des signatures PDF, pas une limite de ce site. Traitez d’abord, signez ensuite.
Essayer ↑Oui — et c’est vérifiable : l’outil s’appuie sur des moteurs open source exécutés dans le navigateur (pdf-lib, pdf.js, Tesseract OCR…) sur votre propre appareil. Ouvrez DevTools → Network pendant le traitement : aucun envoi de fichier.
Essayer ↑Outils associés
PDF scanné en Word
Obtenez un .docx modifiable à partir de votre PDF
Relevé bancaire PDF en Excel
Envoyez un relevé bancaire PDF et obtenez un .xlsx aux colonnes alignées — date / libellé / débit / crédit / solde exactement comme imprimés, prêt pour votre logiciel comptable
PDF en images
Rendez chaque page du PDF en image JPG ou PNG et téléchargez le tout dans un zip