PDF escaneado a texto (OCR)
¿Tu PDF escaneado es solo una imagen y no puedes seleccionar ni copiar el texto? Súbelo y el OCR lo convierte en texto copiable, generando un .txt y un PDF con búsqueda (una capa de texto invisible sobre las páginas originales, lista para búsqueda de texto completo). Elige entre 9 idiomas de reconocimiento. El reconocimiento se ejecuta localmente en tu navegador; tu archivo nunca se sube.
- Sube el escaneo
- OCR local
- Descarga el texto
Arrastra tu archivo aquí
o elígelos desde tu dispositivo — sin registro
Los archivos se procesan localmente en tu navegador — nunca se suben a ningún servidor
Precio previsto de la versión final: $6.9/mes o $49/año · aviso por correo 30 días antes de cobrar · nada se cobra durante la beta
Así se ve el resultado
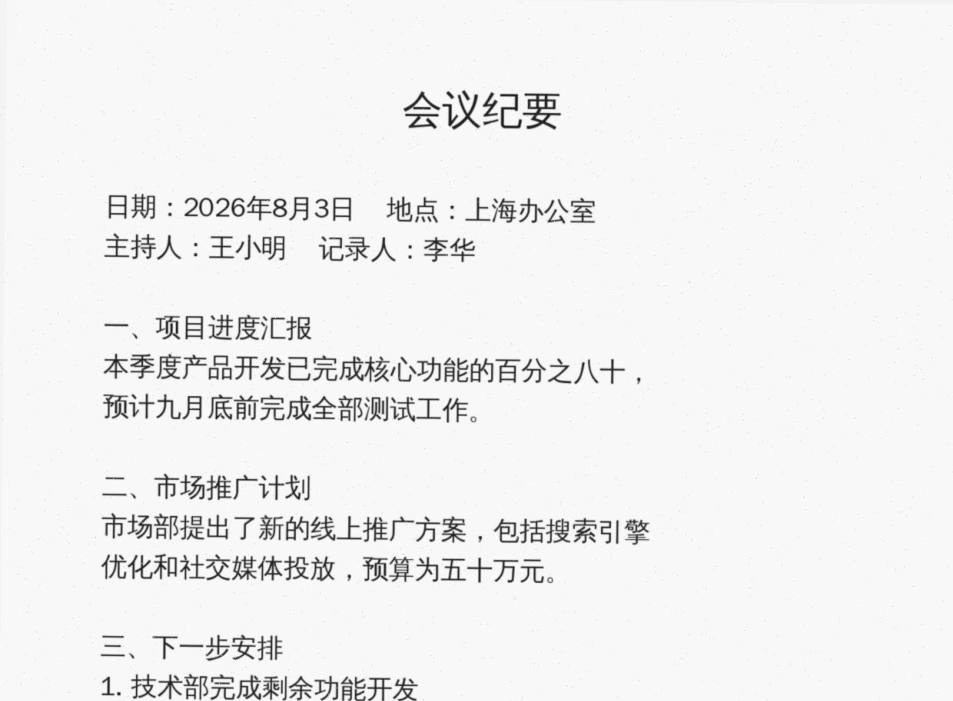
会议纪要
日期: 2026 年 8 月 3 日 ”地点:上海办公室
主持人:王小明 ”记录人:李华
一、项目进度汇报
本季度产品开发已完成核心功能的百分之八十,
预计九月底前完成全部测试工作。
El texto de arriba es un extracto sin editar de lo que nuestro motor OCR produjo realmente con el escaneo de ejemplo. Pulsa «Probar con un PDF de ejemplo» arriba para reproducirlo.
Cómo funciona (3 pasos)
Sube el escaneo
Se admiten PDF escaneados e imágenes PNG/JPG; elige el idioma de reconocimiento de tu documento.
OCR local
Las páginas se reconocen una a una con progreso visible; los escaneos impresos nítidos dan alta precisión. El modelo de OCR se ejecuta dentro de tu navegador.
Descarga el texto
Obtienes un .txt de texto plano y un PDF con búsqueda que conserva el diseño original.
Búsquedas populares
- convertir PDF escaneado a texto
- extraer texto de PDF escaneado
- hacer un PDF escaneado buscable
Preguntas frecuentes
El texto impreso escaneado a 300dpi o más se reconoce bien; el contenido inclinado, borroso o manuscrito pierde bastante precisión — revisa cifras y nombres clave tras el OCR.
Pruébalo ↑Se ve idéntico al escaneo original, pero cada página lleva una capa de texto invisible: puedes seleccionar y copiar texto, buscar con Ctrl+F y los gestores documentales pueden indexarlo.
Pruébalo ↑Chino simplificado y tradicional, inglés, japonés, coreano, alemán, francés, español y portugués — 9 en total; las opciones no inglesas reconocen texto mixto con inglés automáticamente.
Pruébalo ↑No — el OCR se ejecuta íntegramente en tu navegador. El modelo de reconocimiento se descarga de un CDN en el primer uso (ver el aviso del pie de página).
Pruébalo ↑No. Cualquier cambio en un PDF firmado (unir, comprimir, marca de agua…) invalida la firma digital existente: es el diseño antimanipulación de las firmas PDF, no un límite de este sitio. Procesa primero y firma después.
Pruébalo ↑Sí, y puedes verificarlo: la herramienta usa motores de código abierto dentro del navegador (pdf-lib, pdf.js, Tesseract OCR…) en tu propio dispositivo. Abre DevTools → Network durante el procesamiento y verás que no hay ninguna subida de archivos.
Pruébalo ↑Herramientas relacionadas
OCR — PDF a texto
Convierte PDFs escaneados en texto seleccionable y con búsqueda en 9 idiomas de reconocimiento (español, inglés, chino simplificado/tradicional, japonés, coreano, alemán, francés, portugués) — exporta .txt o un PDF con capa de texto
PDF escaneado a Word
Obtén un .docx editable a partir de tu PDF
Tabla de PDF a Excel
Extrae tablas de cualquier PDF con texto a .xlsx o CSV — facturas, informes, listas de precios, extractos