Gescanntes PDF in Text (OCR)
Ihr gescanntes PDF ist nur ein Bild — Text lässt sich weder markieren noch kopieren? Laden Sie es hoch: OCR macht daraus kopierbaren Text und erzeugt sowohl eine .txt-Datei als auch ein durchsuchbares PDF (eine unsichtbare Textebene über den Originalseiten, bereit für Volltextsuche). 9 Erkennungssprachen stehen zur Wahl. Die Erkennung läuft lokal in Ihrem Browser; Ihre Datei wird nie hochgeladen.
- Scan hochladen
- Lokale OCR
- Text herunterladen
Datei hier ablegen
oder vom Gerät auswählen — ohne Registrierung
Dateien werden lokal in Ihrem Browser verarbeitet — nie auf einen Server hochgeladen
Preisvorschau der Vollversion: $6.9/Monat oder $49/Jahr · E-Mail-Ankündigung 30 Tage vor Zahlungsbeginn · während der Beta wird nichts berechnet
So sieht das Ergebnis aus
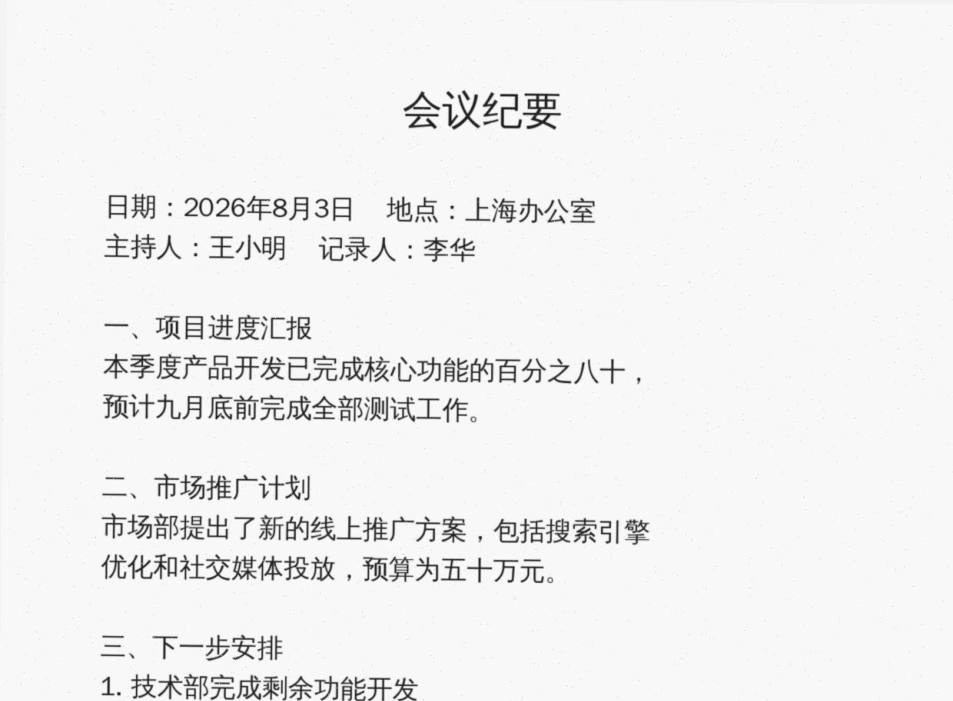
会议纪要
日期: 2026 年 8 月 3 日 ”地点:上海办公室
主持人:王小明 ”记录人:李华
一、项目进度汇报
本季度产品开发已完成核心功能的百分之八十,
预计九月底前完成全部测试工作。
Der Text oben ist ein unbearbeiteter Auszug dessen, was unsere OCR-Engine aus dem Beispielscan tatsächlich erzeugt hat. Klicken Sie oben auf „Mit Beispiel-PDF testen“, um es selbst zu reproduzieren.
So funktioniert es (3 Schritte)
Scan hochladen
Gescannte PDFs und PNG/JPG-Bilder werden unterstützt; wählen Sie die Erkennungssprache Ihres Dokuments.
Lokale OCR
Die Seiten werden nacheinander mit sichtbarem Fortschritt erkannt; klare Druckscans liefern hohe Genauigkeit. Das OCR-Modell läuft in Ihrem Browser.
Text herunterladen
Sie erhalten eine reine .txt-Datei und ein durchsuchbares PDF, das das Originallayout behält.
Beliebte Suchanfragen
- gescanntes PDF in Text umwandeln
- Text aus gescanntem PDF extrahieren
- gescanntes PDF durchsuchbar machen
Häufige Fragen
Drucktext mit 300dpi oder besser wird gut erkannt; schiefe, unscharfe oder handschriftliche Inhalte deutlich schlechter — prüfen Sie wichtige Zahlen und Namen nach der OCR.
Ausprobieren ↑Es sieht identisch zum Originalscan aus, aber jede Seite trägt eine unsichtbare Textebene — Text lässt sich markieren und kopieren, mit Strg+F durchsuchen, und Dokumentsysteme können es indexieren.
Ausprobieren ↑Vereinfachtes und traditionelles Chinesisch, Englisch, Japanisch, Koreanisch, Deutsch, Französisch, Spanisch und Portugiesisch — 9 insgesamt; nicht-englische Optionen erkennen Mischtext mit Englisch automatisch.
Ausprobieren ↑Nein — OCR läuft vollständig in Ihrem Browser. Das Erkennungsmodell wird beim ersten Gebrauch von einem CDN geladen (siehe Hinweis in der Fußzeile).
Ausprobieren ↑Nein. Jede Änderung an einem signierten PDF (Zusammenführen, Komprimieren, Wasserzeichen…) macht die vorhandene digitale Signatur ungültig — das ist der Manipulationsschutz von PDF-Signaturen, keine Einschränkung dieser Seite. Erst verarbeiten, dann signieren.
Ausprobieren ↑Ja — und Sie können es überprüfen: Das Werkzeug nutzt quelloffene In-Browser-Engines (pdf-lib, pdf.js, Tesseract OCR …) auf Ihrem eigenen Gerät. Öffnen Sie während der Verarbeitung DevTools → Network: Es gibt keine Datei-Uploads.
Ausprobieren ↑Verwandte Werkzeuge
OCR — PDF in Text
Machen Sie aus gescannten PDFs auswählbaren, durchsuchbaren Text in 9 Erkennungssprachen (Deutsch, Englisch, vereinfachtes/traditionelles Chinesisch, Japanisch, Koreanisch, Französisch, Spanisch, Portugiesisch) — Export als .txt oder durchsuchbares PDF
Gescanntes PDF in Word
Erhalten Sie ein bearbeitbares .docx aus Ihrem PDF
PDF-Tabelle in Excel
Holen Sie Tabellen aus jedem textbasierten PDF in .xlsx oder CSV — Rechnungen, Berichte, Preislisten, Auszüge